在分布式系统中,一致性模型定义了多节点间数据更新的可见顺序与实时性,是权衡性能、可用性和正确性的核心。四个经典模型从强到弱依次为:
-
线性一致性(Linearizability)
-
顺序一致性(Sequential Consistency)
-
因果一致性(Causal Consistency)
-
最终一致性(Eventual Consistency)
越强的一致性模型对系统的性能和可用性要求越高,实际工程需要根据业务场景取舍。
线性一致性
每个操作在现实中需要一段时间才能完成,从逻辑上的“调用(call)开始”到“返回(return)结束”。但在这期间某个瞬间,该操作原子性地生效了,并被其他参与者(线程、节点等)立刻感知到这个变化。
线性一致性保证了系统对外表现得像只有单一副本,无论 client 访问哪个节点,读取到的数据都是一致的。在 Raft 这样的共识协议中,一个操作必须经过多数节点确认,也就是达成共识才能生效,也就对应了操作原子性生效的那个瞬间。
在 CAP 理论中,线性一致对应 $C$(一致性)。当网络分区($P$)发生时,系统必须拒绝请求而不是返回可能过期的数据,因此牺牲了可用性($A$)。Raft、ZooKeeper 等走的就是 CP 优先的道路。
举个例子,用户 A 转账给用户 B 100元,B 立刻查询账户余额必须多出100元而不能是旧值。如果银行网络故障,必须拒绝这个请求,防止写入脏数据。
顺序一致性
顺序一致性比线性一致性稍弱。它要求存在一个操作的全局总序,在这个总序里:
- 一个参与者内的操作保持程序顺序
- 所有参与者看到的内存操作顺序是一致的,但不要求这个顺序与真实时钟一致。
也就是说,操作可以看起来“乱序”发生,但只要所有参与者看到的顺序一致即可。
这点区别其实影响很大。线性一致中,节点 A 在 $T_1$ 完成了写入,节点 B 在 $T_2$ 读取,那么节点 B 必须能读到这个写入。但是顺序一致中不保证,只保证所有参与者看到相同的结果。
举个例子,初始 x=0, y=0
Thread 1: x=1 r1=y
Thread 2: y=1 r2=x
最终结果应该为:r1=1, r2=1
所以可能的合法的执行顺序只有两种:
- T1 执行完两条后,T2 执行两条,T2 看到
x=1, r2=1 - T2 执行完两条后,T1 执行两条,T1 看到
y=1, r1=1
不符合最终结果一致的执行顺序则不符合顺序一致性。
因果一致性
因果一致性更弱,只要求所有参与者必须以相同的顺序看到具有因果关系的操作。假如操作 B 依赖操作 A 的结果,那么所有节点必须先看到 A,再看到 B,此时可以认为 A 与 B 具有因果关系。因果关系可以传递。
因果一致性在性能和正确性之间取得了较好的平衡,适合对顺序有部分要求但不需要全局同步的场景。具有因果关系的操作保证按照顺序生效,其余操作将遵循最终一致性。
Git 是一个很好的例子。你 push 了一个 commit,别人 pull 后看到的历史必须包含你的 commit 以及之前所有依赖 commit。
最终一致性
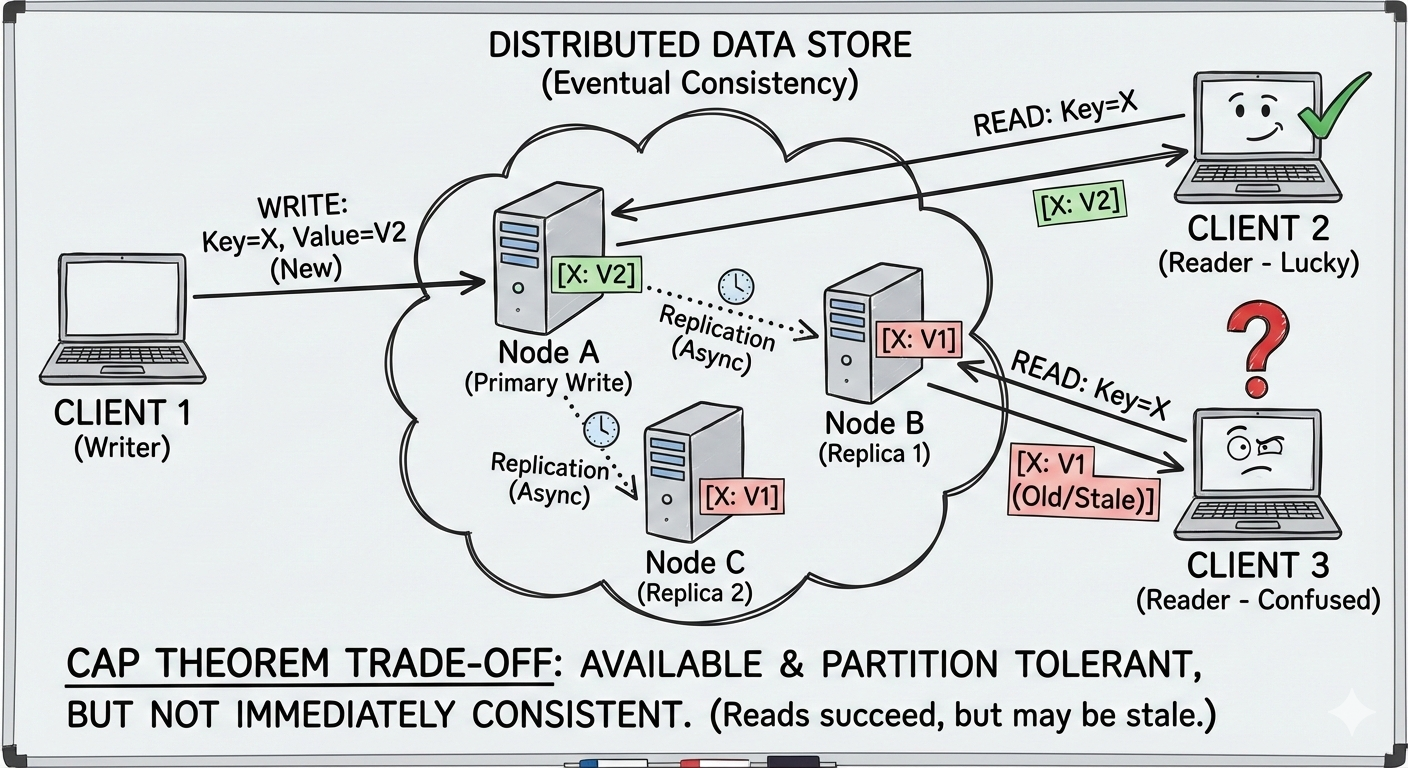
指对于已改变的写的数据的读取,最终都能获得已更新的数据,但不完全保证能立即获取已更新的数据。
也就是说,在一次获取中保证能获得合法的值(如果有),但不保证最新。每个分布式系统节点总是可用的,写操作将最终同步给所有节点。
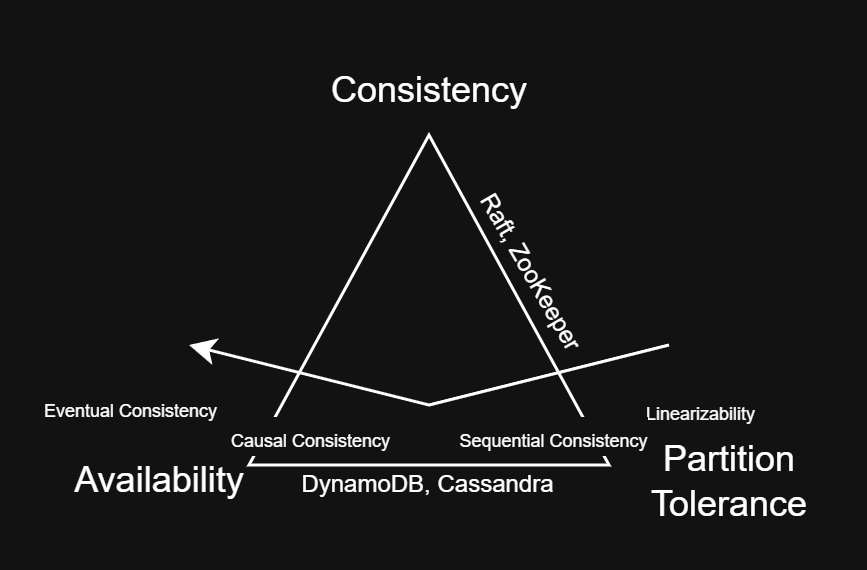
在 CAP 理论中,仅保证最终一致性分布式系统发生网络分区($P$)时,舍弃绝对的一致性($C$)而追求高可用性($A$)。但工程上一般不会止步于此,通常会在此基础上叠加版本号、冲突解决、读修复等机制,尽量缩短不一致的窗口,达到 “$PA$ + 尽可能高的一致性”的效果。
例如 DNS 解析服务,修改 A 记录之后,全球节点陆续更新,不是立刻同步的。
总结
一致性模型本质是分布式系统对“数据新鲜度”的承诺。从线性一致到最终一致,不断放松约束以换取性能和可用性。没有最好的模型,只有最适合的权衡选择。